Gemini 4 Argonが6位に登場! OpenRouterランキングから見るLLM勢力図【2026年10月14日版】
※ 本記事は2026年10月14日時点の情報です。モデル、スコア、価格、提供状況は短期間で変わる可能性があります。
前回の2026年10月2日版から約2週間。OpenRouterのBenchmarksで、Avg Price Per 100 RequestsとArtificial Analysis Intelligence Indexを組み合わせ、LLMの勢力図をもう一度見ていきます。今回の主役は、10月13日に一般提供が始まったGoogleの新しい最上位モデルGemini 4 Argonです。
先に結論を言うと、Gemini 4 ArgonはIntelligence Index 52.6で上位20モデル中6位に初登場しました。前回のGoogleの最上位は20位のGemini 3.8 Flash(40.9)だったので、一気に上位へ戻ってきた形です。GPT-6 Astra(52.7)とほぼ同じスコアを、約3分の1の価格で出しています。
ただし、価格まで含めたパレートフロンティアには入りませんでした。より安く、より高スコアのClaude Sonnet 5.5がすぐ近くにいるためです。フロンティアは前回の7モデルから5モデルに減っています。
今回の「最強コスパAI」のルール
- 縦軸:Artificial Analysis Intelligence Index(高いほど高性能)
- 横軸:Avg Price Per 100 Requests(左へ行くほど安い)
- 表示:Show Paretoを有効化
あるモデルより「スコアが高く、しかも価格が安い」モデルが存在するなら、前者はこの2軸では支配されていると考えます。反対に、単純な上位互換が存在しない選択肢がパレート最適です。それらを結んだ線がパレートフロンティアです。
前回はIntelligence Indexの基準変更(v4.2・v4.3)があり、それ以前の記事と数値を比べられませんでした。今回は基準がv4.3のままで、前回からあったモデルのスコアは1つも変わっていません。10月2日版の数値とは、そのまま比べられます。
今回の主役:Gemini 4 Argonとは
Gemini 4 Argonは、Googleが9月30日に発表した最上位モデルです。発表時点では、Googleのセキュリティの取り組み「Fairwind Program」の一部のパートナーだけに提供され、脆弱性を見つけて直す防御側のサイバーセキュリティ用途が前面に出ていました。10月13日に提供範囲が広がり、開発者や一般の利用者も使えるようになりました。OpenRouterにも同じ10月13日に追加されています。
| 項目 | 内容 |
|---|---|
| 発表 | 2026年9月30日(Fairwind Programのパートナーに限定提供) |
| 一般提供 | 2026年10月13日 |
| 使える場所 | Gemini API(有料枠、モデルID gemini-4-argon)、Google AI Studio、Google Antigravity、Geminiアプリ(Google AI Pro・Ultra)、検索のAIモード、OpenRouter |
| API価格 | 11月30日までは入力100万トークン当たり2ドル、出力10ドル(キャッシュ入力は95%引き)。12月以降は入力4ドル、出力20ドル |
| トークン上限 | 入出力を合わせて100万トークン |
| 入力 | テキスト、画像、動画、音声(出力はテキスト) |
Googleは、コーディング、金融、法務、サイバーセキュリティ、科学といった、何段階にも分かれる仕事に強いと説明しています。Geminiアプリでは、答え方がより直接的になり、繰り返しや決まり文句が減ったとしています。
注意したいのは価格です。今の2ドル/10ドルは11月30日までの導入価格で、12月からは2倍になります。OpenRouterのグラフの位置も、この導入価格で計算されたものです。
2026年10月14日のパレートフロンティア
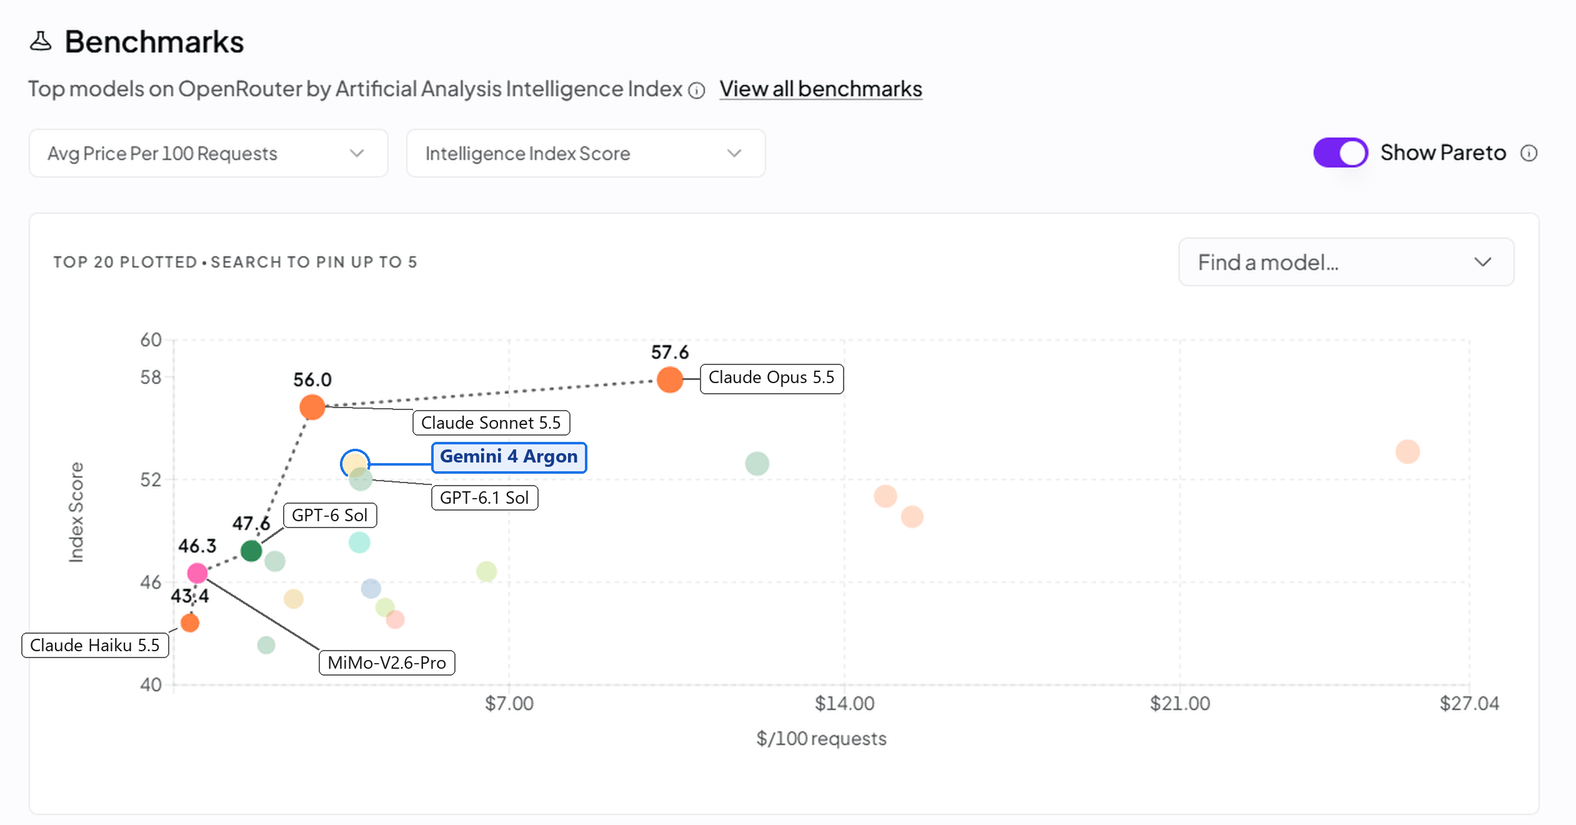
パレートフロンティア上の5モデルを、Intelligence Indexの高い順に並べます。参考として、フロンティアから外れたGemini 4 Argonも入れました。価格はグラフの目盛りから読み取ったおおよその値で、正確な数値ではありません。
| モデル | 開発元 | Index | 100リクエスト当たり(目安) | グラフ上の役割 |
|---|---|---|---|---|
| Claude Opus 5.5 | Anthropic | 57.6 | 約10.3ドル | 最高性能・プレミアム帯 |
| Claude Sonnet 5.5 | Anthropic | 56.0 | 約2.9ドル | 高性能・中価格帯 |
| GPT-6 Sol (Max) | OpenAI | 47.6 | 約1.6ドル | 中価格帯の下限 |
| MiMo-V2.6-Pro | Xiaomi | 46.3 | 約0.4ドル | 低価格帯 |
| Claude Haiku 5.5 (Max) | Anthropic | 43.4 | 約0.3ドル | 最安値側 |
| (参考)Gemini 4 Argon (High) | 52.6 | 約3.7ドル | フロンティアの下 |
Gemini 4 Argonはグラフのどこにいるか
GPT-6 Astra並みのスコアを約3分の1の価格で
Gemini 4 Argonは52.6で、5位のGPT-6 Astra (Max)の52.7とほぼ同じです。一方、グラフ上の価格はGPT-6 Astraの約12ドルに対して、Argonは約3.7ドル。同じくらいの性能を約3分の1の価格で使えることになります。
すぐ近くにいる7位のGPT-6.1 Sol (Max)と比べても、Argonはスコアが0.8ポイント高く、価格は少し安い位置にいます。この2つの比較では、Argonが上位互換です。
それでもフロンティアに入れない理由:Claude Sonnet 5.5
Argonの左上には、Claude Sonnet 5.5(56.0、約2.9ドル)がいます。Sonnet 5.5はArgonより3.4ポイント高く、しかも安いので、この2軸ではArgonはSonnet 5.5に支配されます。前回の記事で「総合3〜5位のモデルをまとめて上回る」と書いたSonnet 5.5が、今回もGoogleの新モデルの前に立ちはだかりました。
興味深いのは、OpenRouterでのトークン単価です。Gemini 4 Argon(導入価格)もClaude Sonnet 5.5も、入力100万トークン当たり2ドル、出力10ドルで同じです。それなのに100リクエスト当たりの価格に差が出るのは、1回の依頼で使うトークンの量が違うためと考えられます。Artificial Analysisの測定でも、Argonは1つの課題に平均6万2千トークンを出力していて、GPT-6 Astra (Max)の2万7千トークンの2倍以上でした。じっくり考えて長く書くぶん、費用もかさむモデルです。
12月からは価格が2倍に
今の位置は導入価格によるものです。12月にトークン単価が2倍になり、使い方が今と同じなら、100リクエスト当たりの価格も単純計算で約7ドル台になります。そうなると、GPT-6 Astraよりは安いものの、Sonnet 5.5との差はさらに広がります。導入価格の期間は、Argonを試すにはよい時期と言えます。
Artificial Analysisの個別評価で見る得意・不得意
Intelligence Indexは10種類の評価をまとめた総合点です。Artificial Analysisは、発表日の9月30日にArgonの個別の結果も公開しています(推論の設定はHigh)。主な項目を抜き出します。
| 評価 | Gemini 4 Argon | 比較 |
|---|---|---|
| AutomationBench-AA(業務の自動化) | 78%(1位) | Claude Sonnet 5.5 (Max):71% |
| AA-Briefcase(エージェント型の知的作業) | 採点基準の合格率65%(過去最高) | — |
| AA-Omniscience 幻覚率(低いほどよい) | 15% | GPT-6 Astra (Max):51%、GPT-6.1 Sol (Max):54% |
| AA-Omniscience 正答率 | 50% | GPT-6 Astra (Max):63% |
| Terminal-Bench 4(端末操作のコーディング) | 57% | Claude Sonnet 5.5 (Max):64%、Claude Opus 5.5 (Max):60%、GPT-6 Astra (Max):59% |
業務の自動化や、資料を読んでまとめる知的作業では、Argonがトップクラスです。幻覚率15%は、Intelligence Indexが45以上のモデルの中で最も低い値です。ただし正答率はGPT-6 Astraより13ポイント低いので、「知識が多い」というより、知らないことを知らないと答えやすいモデルと読むのがよさそうです。
一方、端末を操作するコーディング(Terminal-Bench 4)では、Claude Sonnet 5.5、Claude Opus 5.5、GPT-6 Astraに届いていません。コーディング用のエージェントとして選ぶなら、現時点ではClaudeやGPTのほうが一歩前にいます。
なお、Googleの発表では、Vals AIの総合指標で1位になったことや、社内での開発効率の向上などが紹介されています。これらはGoogle自身による報告です。
フロンティアの5モデル
絶対王者:Claude Opus 5.5
Claude Opus 5.5は57.6で、今回も首位です。グラフ上の価格は約12ドルから約10.3ドルに下がりました。それでもSonnet 5.5との価格差は約3.6倍あり、スコアの上積みは1.6ポイントです。「費用をかけてでも最高性能」という位置づけは変わりません。
今回も最強の一点:Claude Sonnet 5.5
Claude Sonnet 5.5は56.0で2位。価格は約3.4ドルから約2.9ドルに下がり、前回よりさらに有利な位置に来ました。3位以下のClaude Fable 5.1(53.4)、GPT-6 Astra(52.7)、Gemini 4 Argon(52.6)、GPT-6.1 Sol(51.8)は、どれもSonnet 5.5より低スコアで、しかも高価格側にいます。新しく入ったArgonを含めて、上位勢をまとめて支配しているのがSonnet 5.5です。
OpenAIはGPT-6 Solだけが残る
前回、OpenAIは中価格帯にGPT-6.1 Sol、GPT-6 Sol、GPT-5.6 Solの3モデルを並べていました。今回残ったのはGPT-6 Sol (Max)(47.6、約1.6ドル)だけです。GPT-6 Solの価格が約2.9ドルから約1.6ドルに下がったことで、近くにいたGPT-5.6 Sol(47.0、約2.1ドル)は「GPT-6 Solより低スコアで高い」位置になりました。GPT-6.1 Solは逆に約3.9ドルへ上がり、Sonnet 5.5とArgonの両方に支配されています。
GPT-6 SolとSonnet 5.5の間は、約1.3ドルの差で8.4ポイント上がる大きな段差です。1リクエスト当たり約1.3セント余分に払えるなら、Sonnet 5.5まで一気に上がる価値があります。
低価格帯:MiMo-V2.6-Pro
XiaomiのMiMo-V2.6-Proは46.3、約0.4ドルで、前回に続いてフロンティアに残りました。GPT-6 Solとの差は1.3ポイントで、価格は約4分の1です。安くて強い位置は今回も健在です。
最安値側の新顔:Claude Haiku 5.5
10月7日にOpenRouterに追加されたClaude Haiku 5.5は、43.4、約0.3ドルでフロンティアの最安値側に入りました。前回この位置にいたGLM 5.3 Flash(41.8)は、上位20モデルから外れています。Anthropicは、Haiku 5.5で最上位から最安値側まで、フロンティアの両端を押さえたことになります。
10月2日版から何が変わったか
| 10月2日版(7モデル) | 10月14日版(5モデル) |
|---|---|
| Claude Opus 5.5 | Claude Opus 5.5 |
| Claude Sonnet 5.5 | Claude Sonnet 5.5 |
| GPT-6.1 Sol | — |
| GPT-6 Sol | GPT-6 Sol |
| GPT-5.6 Sol | — |
| MiMo-V2.6-Pro | MiMo-V2.6-Pro |
| GLM 5.3 Flash | Claude Haiku 5.5 |
- Google:Gemini 4 Argonが6位に初登場。上位20の中でのGoogleの最上位は、20位から6位に上がりました。ただしフロンティアには入っていません
- Anthropic:Opus 5.5とSonnet 5.5が上位2枠を守り、Haiku 5.5が最安値側に入りました。フロンティア5モデルのうち3モデルがAnthropicです
- OpenAI:3モデルから、GPT-6 Solの1モデルに減りました
- Z.ai:GLM 5.3 Flashが上位20から外れ、フロンティアから姿を消しました
- Meta:Muse Spark 1.3 (Max)が48.1で10位に入りました
スコアは前回と同じなので、フロンティアの顔ぶれが変わった理由は、新しいモデルの登場と、グラフ上の価格の変化です。わずか2週間でも、価格の動きだけで勢力図が大きく変わることが分かります。
上位20モデル全体の勢力図
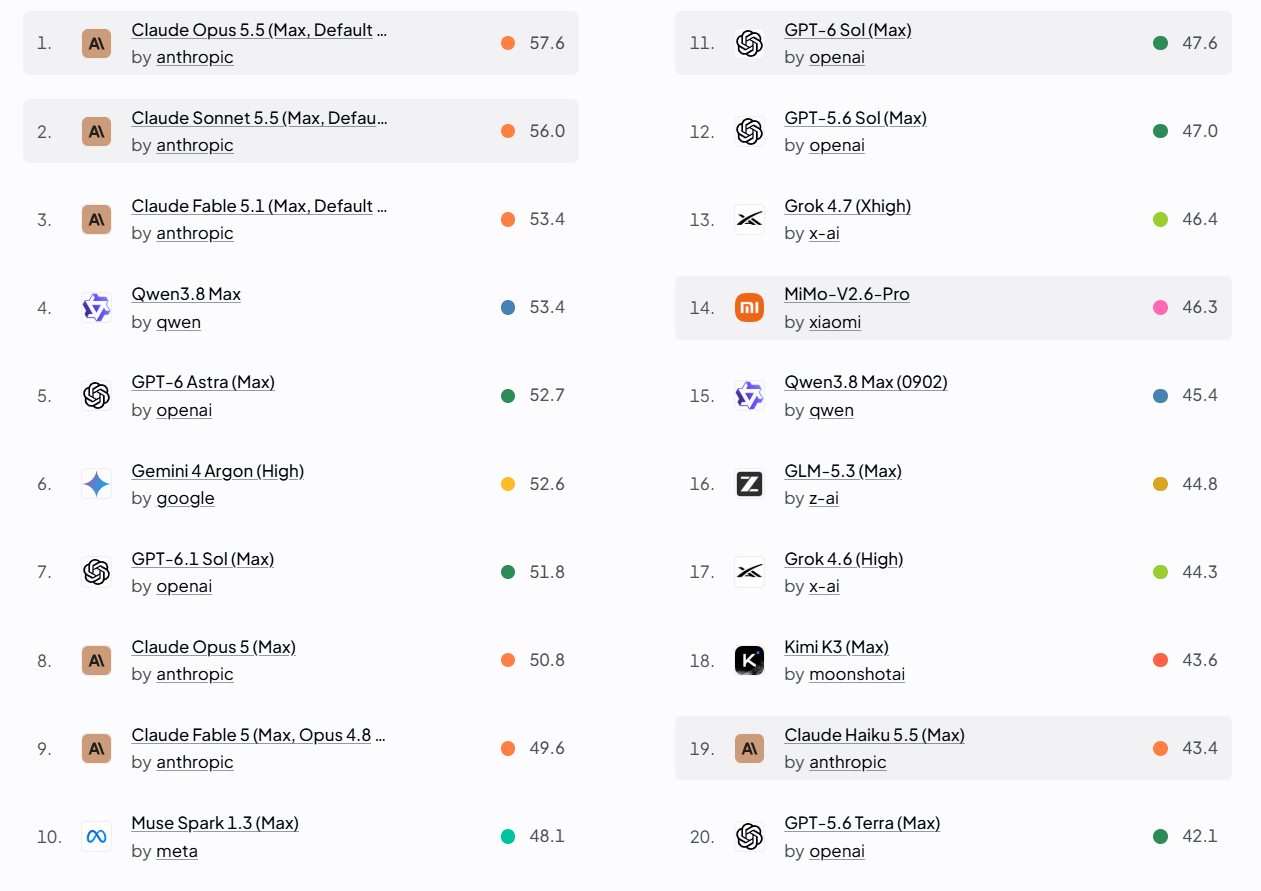
上位20モデルを開発元ごとに数えると、Anthropicが6モデル、OpenAIが5モデルで、前回と同じく2社で半数以上を占めています。上位10位までには、この2社のほかにQwen3.8 Max(4位)、Gemini 4 Argon(6位)、Muse Spark 1.3(10位)が入りました。
| 開発元 | 上位20のモデル数 | 最上位 |
|---|---|---|
| Anthropic | 6 | Claude Opus 5.5(1位) |
| OpenAI | 5 | GPT-6 Astra (Max)(5位) |
| Qwen | 2 | Qwen3.8 Max(4位) |
| xAI | 2 | Grok 4.7 (Xhigh)(13位) |
| 1 | Gemini 4 Argon (High)(6位) | |
| Meta | 1 | Muse Spark 1.3 (Max)(10位) |
| Xiaomi | 1 | MiMo-V2.6-Pro(14位) |
| Z.ai | 1 | GLM-5.3 (Max)(16位) |
| Moonshot AI | 1 | Kimi K3 (Max)(18位) |
Gemini 4 ArgonとMuse Spark 1.3が入ったことで、米国勢の厚みが増しました。上位10位のうち9モデルが米国の4社のモデルです。中国勢は、Qwen、Xiaomi、Z.ai、Moonshot AIの4社が顔を出し、そのうちXiaomiのMiMo-V2.6-Proがフロンティアに残っています。
このランキングの弱点
Avg Price Per 100 Requestsは直感的ですが、同じ100個の質問を全モデルに与えた厳密な比較ではありません。モデルごとに、プロンプトの長さ、出力の長さ、用途、推論量、キャッシュ利用などが異なります。公開されたばかりのGemini 4 Argonは利用の実績がまだ少なく、今後使われ方が変われば、グラフ上の価格も動くはずです。
この価格は同じ日のうちにも更新されます。今回のスクリーンショットの後にページを開き直すと、ArgonとSonnet 5.5の価格はほぼ同じ(どちらも約3.2ドル)になっていて、フロンティアの顔ぶれも少し変わっていました。それでも、スコアの高いSonnet 5.5がArgonを上回る関係は変わりません。細かい順位より、どのあたりの価格帯にいるかを見るのが適切です。
また、推論の設定もそろっていません。Gemini 4 Argonは「High」、Claudeや多くのGPTは「Max」の結果です。4位のQwen3.8 Maxのように、価格のデータがなくグラフに表示されないモデルもあります。
Intelligence Indexは総合指標です。前の節で見たように、Argonは業務の自動化では1位でも、端末操作のコーディングでは上位に届きません。用途を限定すれば順位は変わります。このグラフは候補を絞るための地図として使い、最終判断では自分のプロンプトとデータを使って、成功率、総費用、応答時間を実測するのが確実です。
まとめ
2026年10月14日時点で、Gemini 4 ArgonはIntelligence Index 52.6の6位に初登場し、Googleを上位に引き戻しました。GPT-6 Astraとほぼ同じスコアを約3分の1の価格で出し、業務の自動化や幻覚の少なさでは最上位クラスの結果を残しています。
ただ、価格まで含めたパレートフロンティアには届きませんでした。同じトークン単価で、より高スコアのClaude Sonnet 5.5がより安い位置にいるためです。フロンティアは、Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Sol、MiMo-V2.6-Pro、Claude Haiku 5.5の5モデルになりました。
Argonの導入価格は11月30日まで。12月に価格が2倍になったとき、そして利用が増えて使われ方が落ち着いたとき、グラフ上の位置がどう動くかを、引き続き追っていきます。
参考:OpenRouter Rankings/Gemini 4 Argon: Built to solve your hardest problems(Google)/Gemini 4 Argon is now available in the Gemini app(Google)/Gemini 4 Argon: Google is back as one of the top three labs in intelligence achieved(Artificial Analysis)/Artificial Analysis Intelligence Index v4.3/前回:2026年10月2日版