Claude Sonnet 5.5が急浮上! OpenRouterランキングから見るLLM勢力図【2026年10月2日版】
※ 本記事は2026年10月2日時点の情報です。モデル、スコア、価格、提供状況は短期間で変わる可能性があります。
約1か月ぶりに、OpenRouterのBenchmarksでAvg Price Per 100 RequestsとArtificial Analysis Intelligence Indexを組み合わせ、LLMの勢力図を見ていきます。
先に結論を言うと、絶対性能の首位はClaude Opus 5.5、2位はClaude Sonnet 5.5です。価格まで含めたパレートフロンティアには7モデルが並びました。前回の2026年8月29日版では4モデルだったので、選択肢が大きく広がっています。特に目立つのは、Opus 5.5に1.6ポイント差まで迫りながら、価格は大幅に低い位置にいるClaude Sonnet 5.5です。
今回の「最強コスパAI」のルール
- 縦軸:Artificial Analysis Intelligence Index(高いほど高性能)
- 横軸:Avg Price Per 100 Requests(左へ行くほど安い)
- 表示:Show Paretoを有効化
あるモデルより「スコアが高く、しかも価格が安い」モデルが存在するなら、前者はこの2軸では支配されていると考えます。反対に、単純な上位互換が存在しない選択肢がパレート最適です。それらを結んだ線がパレートフロンティアです。
なお、このグラフはLLM市場全体の利用シェアを表すものではありません。OpenRouterで使われている上位モデルについて、性能指標と100リクエスト当たりの平均価格を比較したスナップショットです。
先に注意:Intelligence Indexの基準が変わった
今回のグラフは、縦軸の目盛りが前回より全体に低くなっています。これはモデルの性能が落ちたのではなく、Artificial Analysisが9月にIntelligence Index v4.2(9月4日)とv4.3(9月7日)を相次いで公開し、評価の中身を入れ替えたためです。
- v4.2:エージェント型の知的作業を評価するAA-Briefcaseと、長いPDF文書の読解を評価するGDP.pdfを追加。飽和していたGPQA Diamondを除外し、非公開テストセットの比重を40%に引き上げ
- v4.3:Terminal-Benchを2.1から4.0へ更新し、業務自動化のベンチマークAutomationBench-AAを追加
同じモデルで比べると違いがよく分かります。前回60.9だったGPT-5.6 Sol (max)は今回47.0、63.1だったClaude Opus 5は50.8です。より難しく、より実務に近い課題に入れ替わったため、全体のスコアが下がりました。前回の記事の数値と今回の数値は、そのまま比べられません。本記事でも、前回との比較は「どのモデルがフロンティアに残ったか」という顔ぶれだけで行います。
2026年10月2日のパレートフロンティア
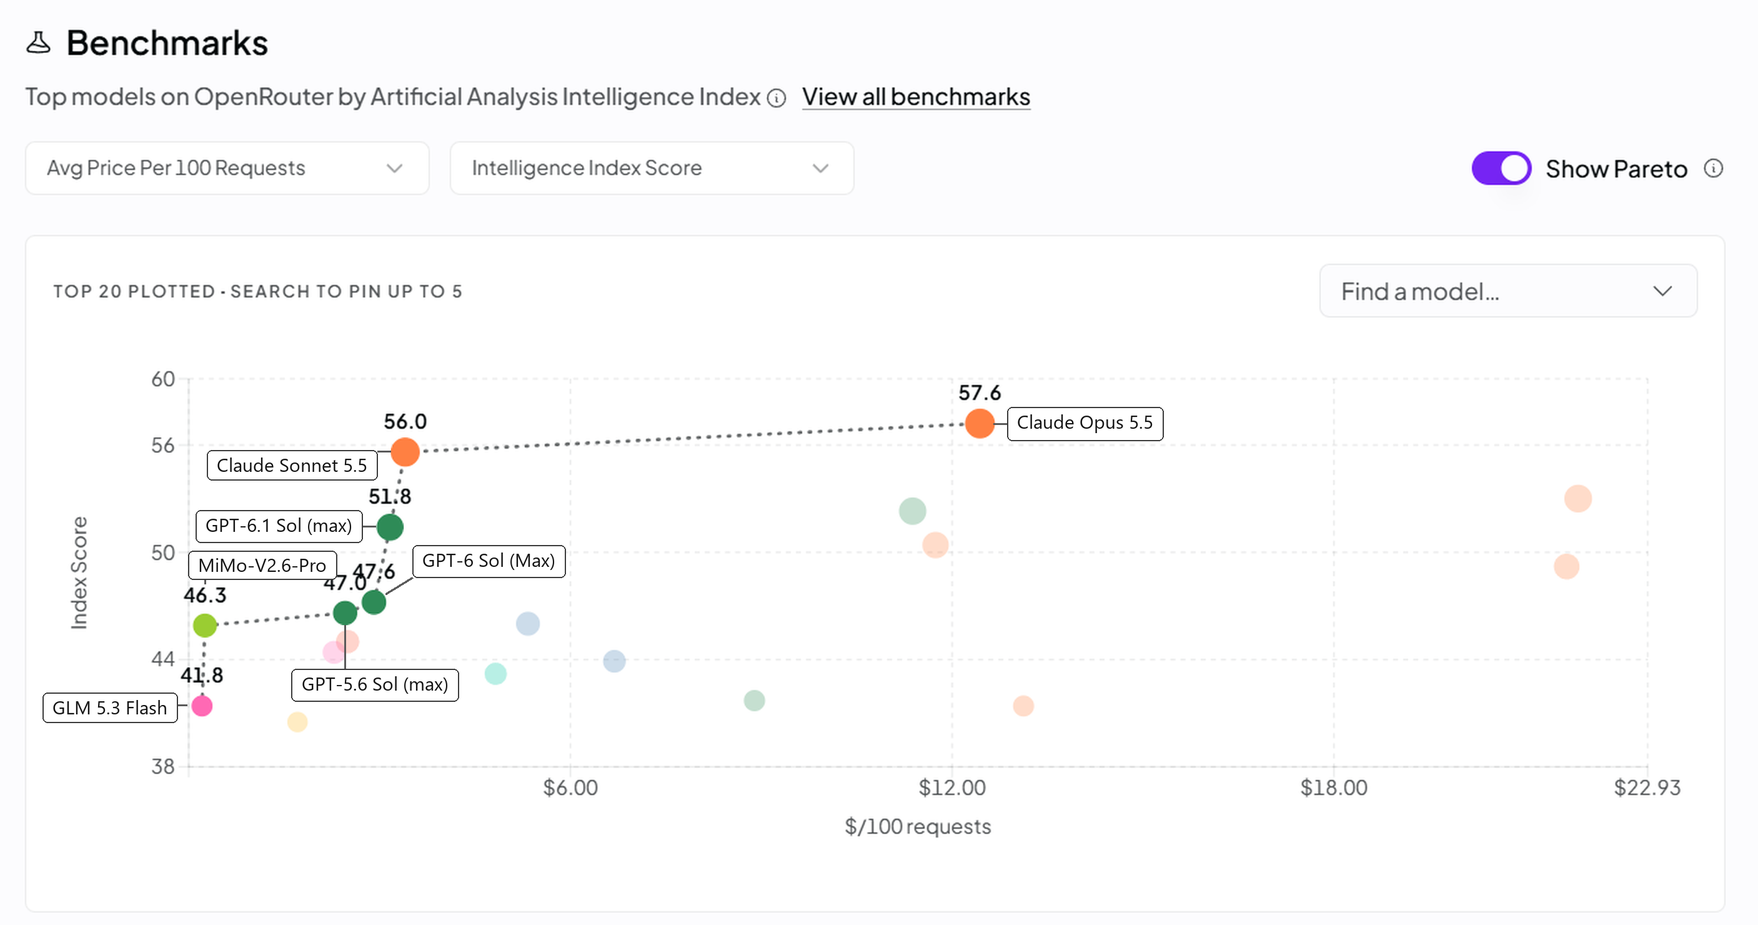
パレートフロンティア上の7モデルを、Intelligence Indexの高い順に並べます。価格はグラフの目盛りから読み取ったおおよその値で、正確な数値ではありません。
| モデル | 開発元 | Index | 100リクエスト当たり(目安) | グラフ上の役割 |
|---|---|---|---|---|
| Claude Opus 5.5 | Anthropic | 57.6 | 約12ドル | 最高性能・プレミアム帯 |
| Claude Sonnet 5.5 | Anthropic | 56.0 | 約3.4ドル | 高性能・中価格帯 |
| GPT-6.1 Sol (max) | OpenAI | 51.8 | 約3.2ドル | 中価格帯 |
| GPT-6 Sol (Max) | OpenAI | 47.6 | 約2.9ドル | 中価格帯 |
| GPT-5.6 Sol (max) | OpenAI | 47.0 | 約2.5ドル | 中価格帯の下限 |
| MiMo-V2.6-Pro | Xiaomi | 46.3 | 約0.3ドル | 低価格帯 |
| GLM 5.3 Flash | Z.ai | 41.8 | 約0.2ドル | 最安値側 |
7階級を見てみる
絶対王者:Claude Opus 5.5
Claude Opus 5.5はIntelligence Index 57.6で、今回の上位20モデル中トップです。グラフでは約12ドルの位置にあり、パレート上の7モデルの中では飛び抜けて高価です。「費用をかけてでも最高性能を選ぶ」というプレミアム級の王者です。
一方、Opus 5.5とSonnet 5.5の間には、パレート線がほぼ水平に伸びています。価格は約3.6倍になるのに、スコアの上積みは1.6ポイントです。最後の1.6ポイントにこの差額を払う価値があるかどうかは、用途しだいでしょう。
今回の主役:Claude Sonnet 5.5
今回いちばん目を引くのがClaude Sonnet 5.5です。スコアは56.0で総合2位。しかも価格は約3.4ドルと、GPT-6.1 Solとほぼ同じ価格帯にいながら4ポイント以上高いスコアを出しています。
同じ53点台のQwen3.8 MaxとClaude Fable 5.1(いずれも53.4)、52.7のGPT-6 Astra (max)は、どれもSonnet 5.5より低スコアで、しかも高価格側にいます。そのため、これらはパレートフロンティアに入りません。総合3〜5位のモデルがまとめてSonnet 5.5に「支配」されている形で、性能と価格のバランスでは、現時点で最も強い一点と言えます。
中価格帯を固めるOpenAI:GPT-6.1 Sol/GPT-6 Sol/GPT-5.6 Sol
2.5〜3.2ドル付近には、OpenAIのSolシリーズが3世代そろって並びました。GPT-6.1 Solが51.8、GPT-6 Solが47.6、GPT-5.6 Solが47.0です。価格が少し上がるごとにスコアも上がる、きれいな階段になっています。
ただし、このすぐ上にはSonnet 5.5がいます。GPT-6.1 Solから約0.2ドル足すだけで、スコアは4.2ポイント上がる計算です。OpenAIの3モデルは「予算の上限が3ドル前後に決まっている場合の選択肢」という位置づけになります。前回も残っていたGPT-5.6 Solが、新しいGPT-6系と並んでフロンティアに残っている点も興味深いところです。
低価格帯の新顔:MiMo-V2.6-Pro
XiaomiのMiMo-V2.6-Proは46.3です。グラフでは約0.3ドルの位置にあり、GPT-5.6 Sol(47.0)とほぼ同じスコアを10分の1前後の価格で出しています。今回のグラフで最も「安くて強い」位置にいるのはこのモデルです。
2つのグループの間、0.3〜2.5ドルの範囲にはパレート上のモデルがありません。つまり、この価格帯で選べる最適な選択肢は、性能を優先して上のOpenAI勢に行くか、費用を優先してMiMo-V2.6-Proに下がるかのどちらかです。
最安値側:GLM 5.3 Flash
Z.aiのGLM 5.3 Flashは41.8で、グラフの最も左からパレートフロンティアを支えています。前回もフロンティア上にいたモデルで、今回も最安値側の座を守りました。
大量処理、一次分類、下書き生成など、1回当たりの費用が積み上がる用途では、引き続き有力な候補です。また、GLM-5.3系はモデルウェイトが公開されているため、自社の設備で動かすという選択肢も残ります(詳しくは前回の記事を参照してください)。
8月29日版から何が変わったか
スコアの基準が変わったため、数値ではなくフロンティアの顔ぶれで比べます。
| 8月29日版(4モデル) | 10月2日版(7モデル) |
|---|---|
| Claude Opus 5 | Claude Opus 5.5/Claude Sonnet 5.5 |
| GPT-5.6 Sol | GPT-6.1 Sol/GPT-6 Sol/GPT-5.6 Sol |
| GLM-5.3 | MiMo-V2.6-Pro |
| GLM-5.3-Flash | GLM 5.3 Flash |
- Anthropic:Opus 5からOpus 5.5へ世代が進み、さらにSonnet 5.5が加わって、上位2枠を独占しました。前回首位のOpus 5(50.8)は、今回はパレート線の下です
- OpenAI:GPT-5.6 Solに加えて、GPT-6 SolとGPT-6.1 Solが入り、中価格帯を3モデルで固めました
- Z.ai:GLM-5.3 (Max)は44.8で、今回はフロンティアから外れました。代わりに、より安いMiMo-V2.6-Proが低価格帯に入っています。GLM 5.3 Flashは引き続き最安値側に残りました
- Xiaomi:MiMo-V2.6-Proで初めてフロンティアに入りました
前回の「プレミアム帯はAnthropic、中間はOpenAI、低価格側はZ.ai」という三極構造は、大枠では変わっていません。ただし今回は、Anthropicが中価格帯の上端まで降りてきたこと、低価格帯にXiaomiが割って入ったことで、四つの勢力が価格帯ごとにすみ分ける形になりました。
上位20モデル全体の勢力図
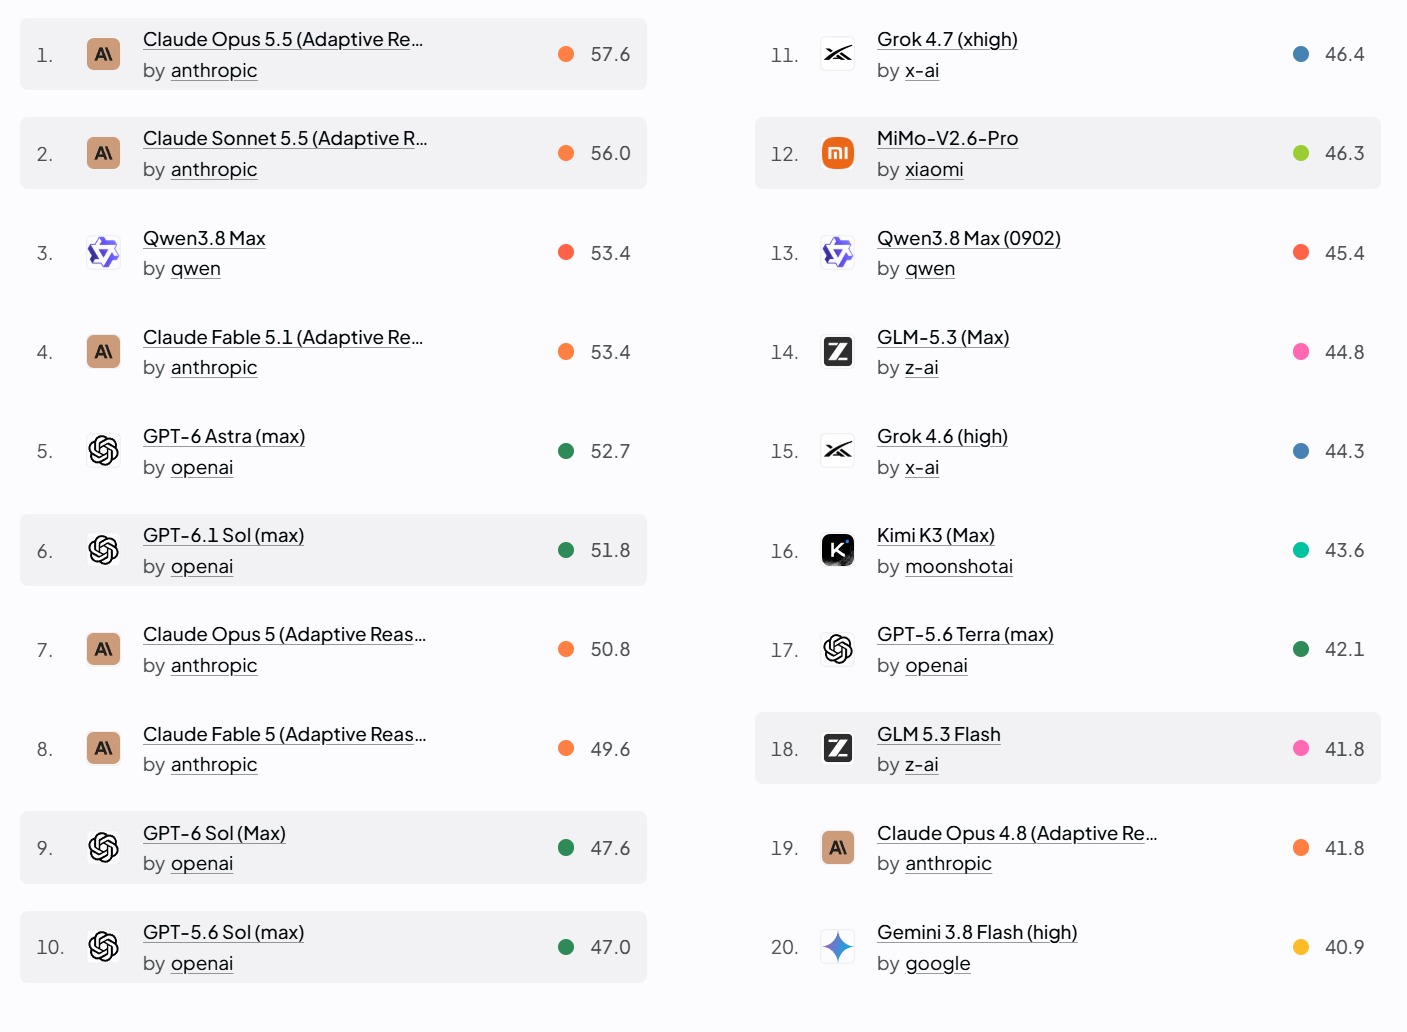
上位20モデルを開発元ごとに数えると、Anthropicが6モデル、OpenAIが5モデルで、2社だけで半数以上を占めています。上位10位までに限ると、この2社以外はQwen3.8 Max(3位)だけです。
| 開発元 | 上位20のモデル数 | 最上位 |
|---|---|---|
| Anthropic | 6 | Claude Opus 5.5(1位) |
| OpenAI | 5 | GPT-6 Astra (max)(5位) |
| Qwen | 2 | Qwen3.8 Max(3位) |
| xAI | 2 | Grok 4.7 (xhigh)(11位) |
| Z.ai | 2 | GLM-5.3 (Max)(14位) |
| Xiaomi | 1 | MiMo-V2.6-Pro(12位) |
| Moonshot AI | 1 | Kimi K3 (Max)(16位) |
| 1 | Gemini 3.8 Flash (high)(20位) |
絶対性能の上位は米国の2社が厚く固めています。一方で、中国勢はQwen、Z.ai、Xiaomi、Moonshot AIの4社が顔を出し、そのうちXiaomiとZ.aiは価格を含めたフロンティアに入っています。「最高性能は米国勢、安さと性能のバランスでは中国勢も強い」という構図は、今回も続いています。
このランキングの弱点
Avg Price Per 100 Requestsは直感的ですが、同じ100個の質問を全モデルに与えた厳密な比較ではありません。モデルごとに、プロンプトの長さ、出力の長さ、用途、推論量、キャッシュ利用などが異なります。高性能モデルには難しく長い仕事が集まり、低価格モデルには短い処理が集まっている可能性もあります。
また、Intelligence Indexは総合指標で、今回のように評価の中身が入れ替わることもあります。コーディング、日本語、エージェント、長文、画像理解など、用途を限定すれば順位は変わります。パレート線より下のモデルにも、速度、安定性、コンテキスト長、ツール対応、データの取り扱いなどで選ぶ理由があります。
このグラフは候補を絞るための地図として使い、最終判断では自分のプロンプトとデータを使って、成功率、総費用、応答時間を実測するのが確実です。
まとめ
2026年10月2日時点の絶対性能トップはClaude Opus 5.5でした。価格まで含めたパレートフロンティアには、Claude Opus 5.5、Claude Sonnet 5.5、GPT-6.1 Sol、GPT-6 Sol、GPT-5.6 Sol、MiMo-V2.6-Pro、GLM 5.3 Flashの7モデルが並んでいます。
今回の主役はClaude Sonnet 5.5です。首位に1.6ポイント差まで迫りながら、価格はOpenAIの中価格帯とほぼ同じ水準にあり、総合3〜5位のモデルをまとめて上回る位置にいます。低価格側では、MiMo-V2.6-ProとGLM 5.3 Flashが、上位モデルの数分の1から数十分の1の価格で踏みとどまっています。
Intelligence Indexの基準変更もあり、勢力図は1か月で大きく描き直されました。次にフロンティアへ入るのはどのモデルか、引き続き追っていきます。
参考:OpenRouter Rankings/Artificial Analysis Intelligence Index v4.2/Artificial Analysis Intelligence Index v4.3/前回:2026年8月29日版