GLM5.3 台頭! OpenRouterランキングから見るLLM勢力図【2026年8月29日版】
※ 本記事は2026年8月29日時点の情報です。モデル、スコア、価格、提供状況は短期間で変わる可能性があります。
AIモデルを選ぶとき、「一番賢いモデル」と「自分の予算で一番強いモデル」は同じとは限りません。最高性能には相応の価格がつきますが、価格帯を少し下げると、性能をあまり落とさずに大きく費用を抑えられるモデルが見つかることがあります。
そこで今回も、OpenRouterのBenchmarksでAvg Price Per 100 RequestsとArtificial Analysis Intelligence Indexを組み合わせ、2026年8月29日時点のLLM勢力図を見ていきます。
先に結論を言うと、絶対性能の首位はClaude Opus 5です。一方、価格まで含めたパレートフロンティアには、Claude Opus 5、GPT-5.6 Sol、GLM-5.3、GLM-5.3-Flashの4モデルが残りました。20日前の2026年8月9日版では7モデルだったため、今回はフロンティアがかなり絞り込まれています。
今回の「最強コスパAI」のルール
- 縦軸:Artificial Analysis Intelligence Index(高いほど高性能)
- 横軸:Avg Price Per 100 Requests(左へ行くほど安い)
- 表示:Show Paretoを有効化
あるモデルより「スコアが高く、しかも価格が安い」モデルが存在するなら、前者はこの2軸では支配されていると考えます。反対に、単純な上位互換が存在しない選択肢がパレート最適です。それらを結んだ線がパレートフロンティアです。
パレートフロンティアは、各価格帯で得られる最高スコアを結んだ線です。今回は、この線上に残ったモデルを「各階級の王者」として見ていきます。
なお、このグラフはLLM市場全体の利用シェアを表すものではありません。OpenRouterの画面で選択した性能指標と、100リクエスト当たりの平均価格を比較したスナップショットです。
2026年8月29日のパレートフロンティア
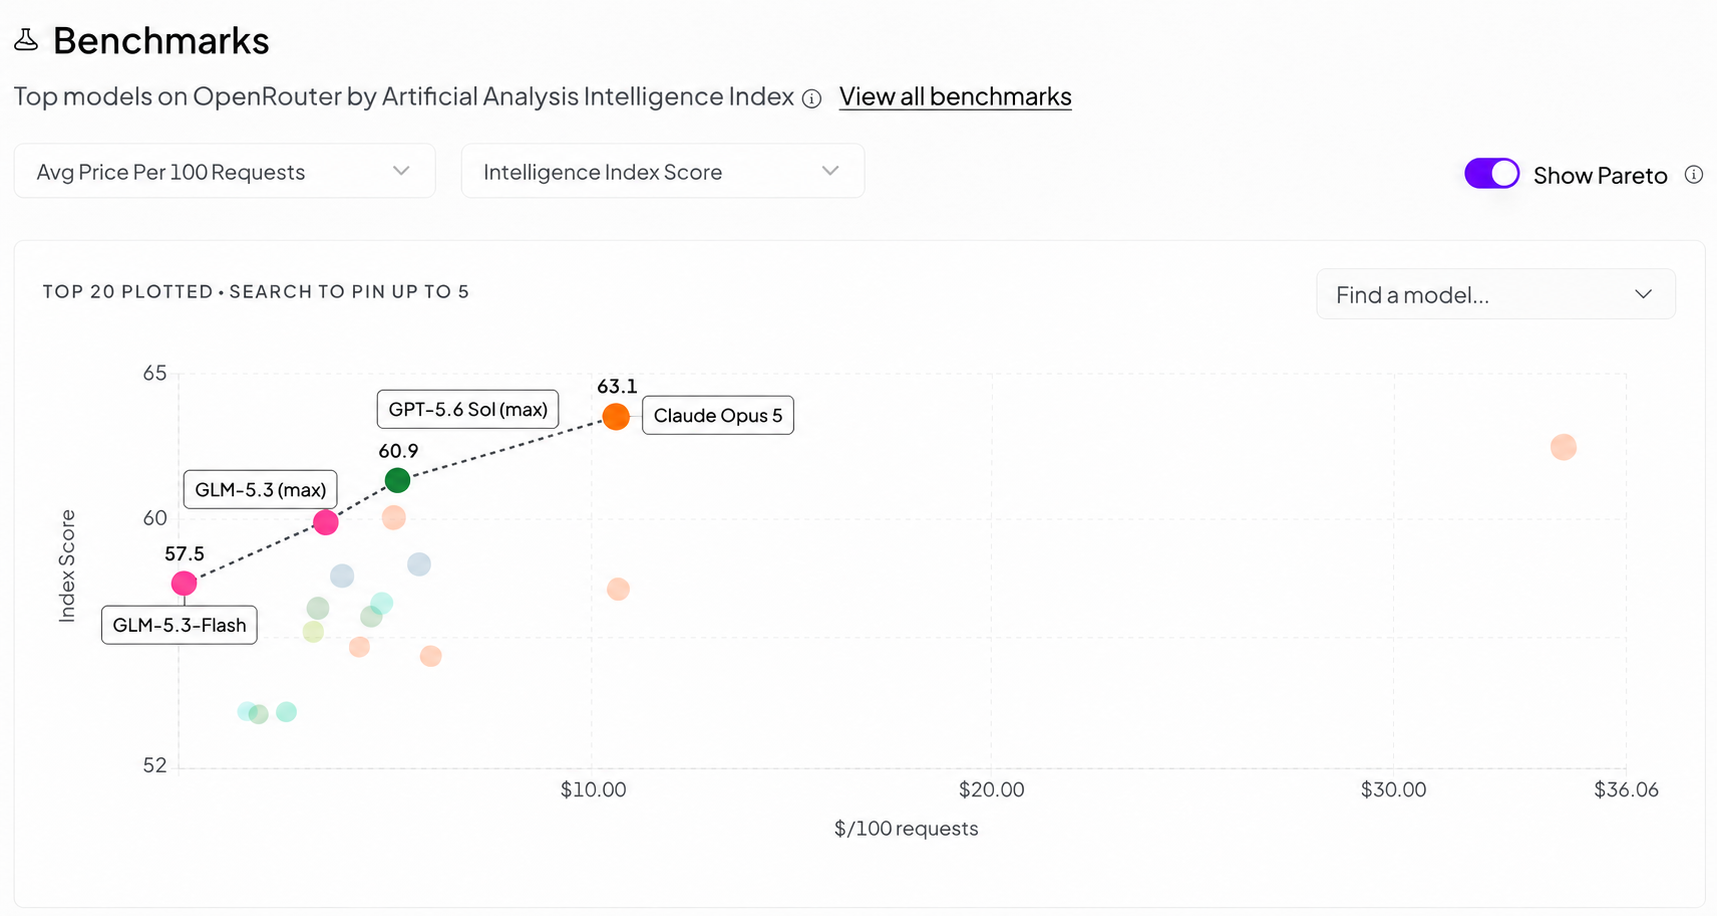
パレートフロンティア上に残った4モデルを、Intelligence Indexの高い順に並べると次のようになります。価格の正確な値は撮影時のツールチップに含まれていないため、画像上の位置から数値を推測せず、価格帯として整理しています。
| モデル | 開発元 | Index | グラフ上の役割 |
|---|---|---|---|
| Claude Opus 5 | Anthropic | 63.1 | 最高性能・プレミアム帯 |
| GPT-5.6 Sol (max) | OpenAI | 60.9 | 高性能・中高価格帯 |
| GLM-5.3 (max) | Z.ai | 59.5 | 高性能・低価格帯 |
| GLM-5.3-Flash | Z.ai | 57.5 | 超低価格側 |
4階級の王者を見てみる
絶対王者:Claude Opus 5
Claude Opus 5はIntelligence Index 63.1で、今回の上位20モデル中トップです。価格は4モデルの中で最も高い位置にありますが、「費用をかけてでも最高性能を選ぶ」というプレミアム級では引き続き王者です。
総合2位のClaude Fable 5は62.1ですが、グラフでは大幅に高価格側にあります。Claude Opus 5のほうが高スコアかつ低価格側にあるため、Fable 5はパレートフロンティアに入りません。総合順位が高くても、価格を組み合わせると評価が変わる好例です。
高性能と価格の接点:GPT-5.6 Sol
GPT-5.6 Solは60.9で、Claude Opus 5に次ぐパレート上の高性能モデルです。最高スコアとの差を抑えながら、グラフでは明確に低価格側へ移ります。最高性能を必要とする場面と、費用を意識した日常利用の間をつなぐ位置です。
同じ60.9のGrok 4.6も上位にいますが、Grok 4.6はGPT-5.6 Solより右側に位置します。スコアが同じなら価格が低いほうがこの2軸では有利になるため、パレート線上に残るのはGPT-5.6 Solです。
今回の主役:GLM-5.3
今回、最も勢力を伸ばしたように見えるのがZ.aiのGLM系です。GLM-5.3は59.5でGPT-5.6 Solに近い性能帯に入りながら、さらに低価格側に位置します。
前号で注目したKimi K3は今回も59.7と高スコアですが、パレート線上には残っていません。Kimi K3の性能が低いという意味ではなく、価格とスコアの組み合わせで、ほかのモデルによる選択肢ができたということです。フロンティアの顔ぶれは、モデルの更新だけでなく、観測される平均費用の変化でも入れ替わります。
GLM-5.3はオープンウェイト
GLM-5.3の大きな特徴は、Z.aiがモデルウェイトを公開していることです。ウェイト、設定ファイル、推論に必要なファイルをダウンロードし、対応する計算環境を用意すれば、自社や研究機関の設備で推論サーバーを構築できます。
GLM-5.3 Licenseは、利用、複製、改変、配布、ファインチューニング、商用利用を認めています。ただし、年間売上100億ドルを超える事業者がModel as a Serviceとして商用利用する場合は、Z.aiのセキュリティレビューが必要です。学習データなどを含むすべてが公開されているとは限らないため、本記事では「完全なオープンソース」ではなく、オープンウェイトと表現します。
これは、条件が整えばフロンティアモデルに近い性能のLLMを、自分たちの管理下で動かせることを意味します。今回のIntelligence Indexでは、首位のClaude Opus 5が63.1、GLM-5.3が59.5です。評価軸を限定した比較ではありますが、閉じたAPIだけに頼らず、機密データを外部へ送らない構成や、独自のファインチューニング、利用量の多い社内基盤を検討できる点は重要です。
GLM-5.3 (max)を手元で動かすには
OpenRouterの表記にあるGLM-5.3 (max)の「max」は、別の巨大モデルを意味するものではありません。GLM-5.3にはlow、high、maxの推論強度があり、maxは最も深く考える設定です。Z.aiはコーディング用途にmaxを推奨しています。深い推論を行うぶん、出力トークン数、処理時間、必要なKVキャッシュは増えやすくなります。
GLM-5.3本体は、約743Bの総パラメータを持つMoEモデルで、1トークンの推論時に約39Bが活性化します。ただし、39B分のVRAMだけで動くわけではありません。入力ごとに異なるエキスパートを呼び出すため、基本的には全体のウェイトをGPUメモリまたはシステムメモリ上に保持する必要があります。
| 用途・形式 | 公式資料に示された構成 | 補足 |
|---|---|---|
| 標準FP8推論 | NVIDIA H200またはH20 141GB × 8枚 | 1ノードで約1.1TBのVRAM。vLLM 0.28.0以降を使用 |
| 1Mトークンのフルコンテキスト | NVIDIA B200 180GB × 8枚 | 合計約1.44TB。FP8 KVキャッシュを使用 |
| AMD GPU | MI300XまたはMI355X × 8枚 | vLLMのROCm構成例では最大コンテキストを524,288に設定 |
| BF16ウェイト | 複数ノード | FP8より大きく、単一ノード向けではない |
標準のFP8チェックポイントだけで約756GBあります。そのため、RTX 5090などVRAM 32GB級のGPUを1枚、あるいは数枚搭載した一般的なワークステーションでは、フル版GLM-5.3をそのままGPUへ載せることはできません。「手元で動かせる」とはいっても、現時点では個人のデスクトップPCというより、自社管理のGPUサーバーや研究用クラスターでセルフホストできるという意味です。
量子化、CPU/RAMへのオフロード、コンテキスト長の制限を組み合わせれば必要VRAMを下げられる可能性はあります。ただし、速度や精度は構成に左右され、OpenRouter上のGLM-5.3 (max)と同じ条件になるとは限りません。より小さい選択肢としては、320B・活性18BのGLM-5.3-Flashもウェイトが公開されていますが、こちらもフル構成はサーバークラスです。
4bit量子化なら、どこまで軽くなるか
743Bパラメータをすべて4bitで保存すると、単純計算では7430億×4bit÷8で約371.5GBです。しかし、実際の量子化モデルでは、精度低下を抑えるためにAttention、ルーター、埋め込み、出力層などの一部を8bitやBF16で残します。メタデータや量子化スケールも必要になるため、実ファイルは理論値より大きくなります。
| 4bit構成 | モデルの実容量 | ハードウェアの目安 | 注意点 |
|---|---|---|---|
| 理論上の純粋な4bit | 約371.5GB | 計算上の最小値 | 実行時メモリやKVキャッシュを含まず、実用構成ではない |
| NVFP4 | 約433GiB(約465GB) | Blackwell世代のB200/B300を8枚使用する構成例 | MoEエキスパートを4bit化し、ほかの重要層は高精度で保持。Blackwell専用 |
| Int4/Int8混合 | 約378GB | DGX Spark 4台(各128GBユニファイドメモリ)での動作実績 | 200Kコンテキストで単一ストリーム約12token/秒。FP8版との品質同等性は未検証 |
| CPU/RAMオフロード | 約400~465GB+実行領域 | 512GB RAMが下限、768GB以上が現実的。保存用に1TB以上のNVMeを推奨 | GPUへ一部だけ載せる構成。全GPU推論より大幅に遅くなる可能性がある |
32GBのGPUだけで約433GiBのウェイトをすべてGPUメモリへ載せるなら、ウェイトだけでも単純計算で14枚分です。実際にはKVキャッシュ、推論エンジン、通信領域の余裕が必要なため、さらに多くのメモリが必要です。4bit量子化しても、RTX 5090を1~2枚という一般的なローカルAI環境へ収まるモデルではありません。
一方、512GB級の大容量ユニファイドメモリを持つ複数台構成や、512~768GB以上のサーバーRAMへウェイトを置いてGPUで一部を処理する構成なら、「自分たちの設備で動かす」という選択肢が見えてきます。速度を重視するなら約500GB以上の総GPUメモリ、コストを抑えるなら大容量RAMとGPUのハイブリッド構成が目安です。
なお、maxにしてもモデルウェイト自体の大きさは変わりません。ただし、maxは長い思考過程を生成しやすいため、長いコンテキストや同時実行数を扱う場合はKVキャッシュと処理時間の余裕が必要です。また、量子化による性能低下の程度は方式ごとに異なり、OpenRouterのランキングに掲載されたGLM-5.3 (max)のスコアを、そのまま4bit版へ当てはめることはできません。
4bit構成の参照:vLLM GLM-5.3 Recipe/GLM-5.3 NVFP4/GLM-5.3 Int4/Int8混合版
参照:Z.ai公式:GLM-5.3/vLLM公式GLM-5.3構成例/Z.ai公式:GLM-5.3-Flash
超低価格級:GLM-5.3-Flash
GLM-5.3-Flashは57.5で、グラフの最も左側からパレートフロンティアを支えています。絶対性能では9位ですが、非常に低価格側に位置しながら、上位モデルに迫るIndexを維持しています。
大量処理、一次分類、下書き生成、繰り返し評価など、1回当たりの費用が積み上がる用途では、この位置は魅力的です。ただし、実務で採用する際は、日本語品質、応答速度、長文処理、ツール利用、構造化出力など、自分の用途に必要な条件を別途確認する必要があります。
8月9日版から何が変わったか
2026年8月9日版では、パレートフロンティア上に次の7モデルが並んでいました。
- Claude Opus 5
- GPT-5.6 Sol
- Kimi K3
- Qwen3.8 Max
- GPT-5.6 Terra
- Muse Spark 1.1
- GPT-5.6 Luna
今回はClaude Opus 5とGPT-5.6 Solが残り、GLM-5.3とGLM-5.3-Flashが加わった4モデル構成です。中価格帯から超低価格帯までをGLM系がまとめて押さえたことで、以前は細かく分かれていた価格階級が一気に圧縮されました。
つまり、2026年8月29日のスナップショットを一言で表すなら、プレミアム帯はAnthropic、高性能と価格の接点はOpenAI、低価格側はZ.aiという三極構造です。しかも、パレート4モデルのうち2モデルをGLM系が占めています。
上位20モデル全体の勢力図
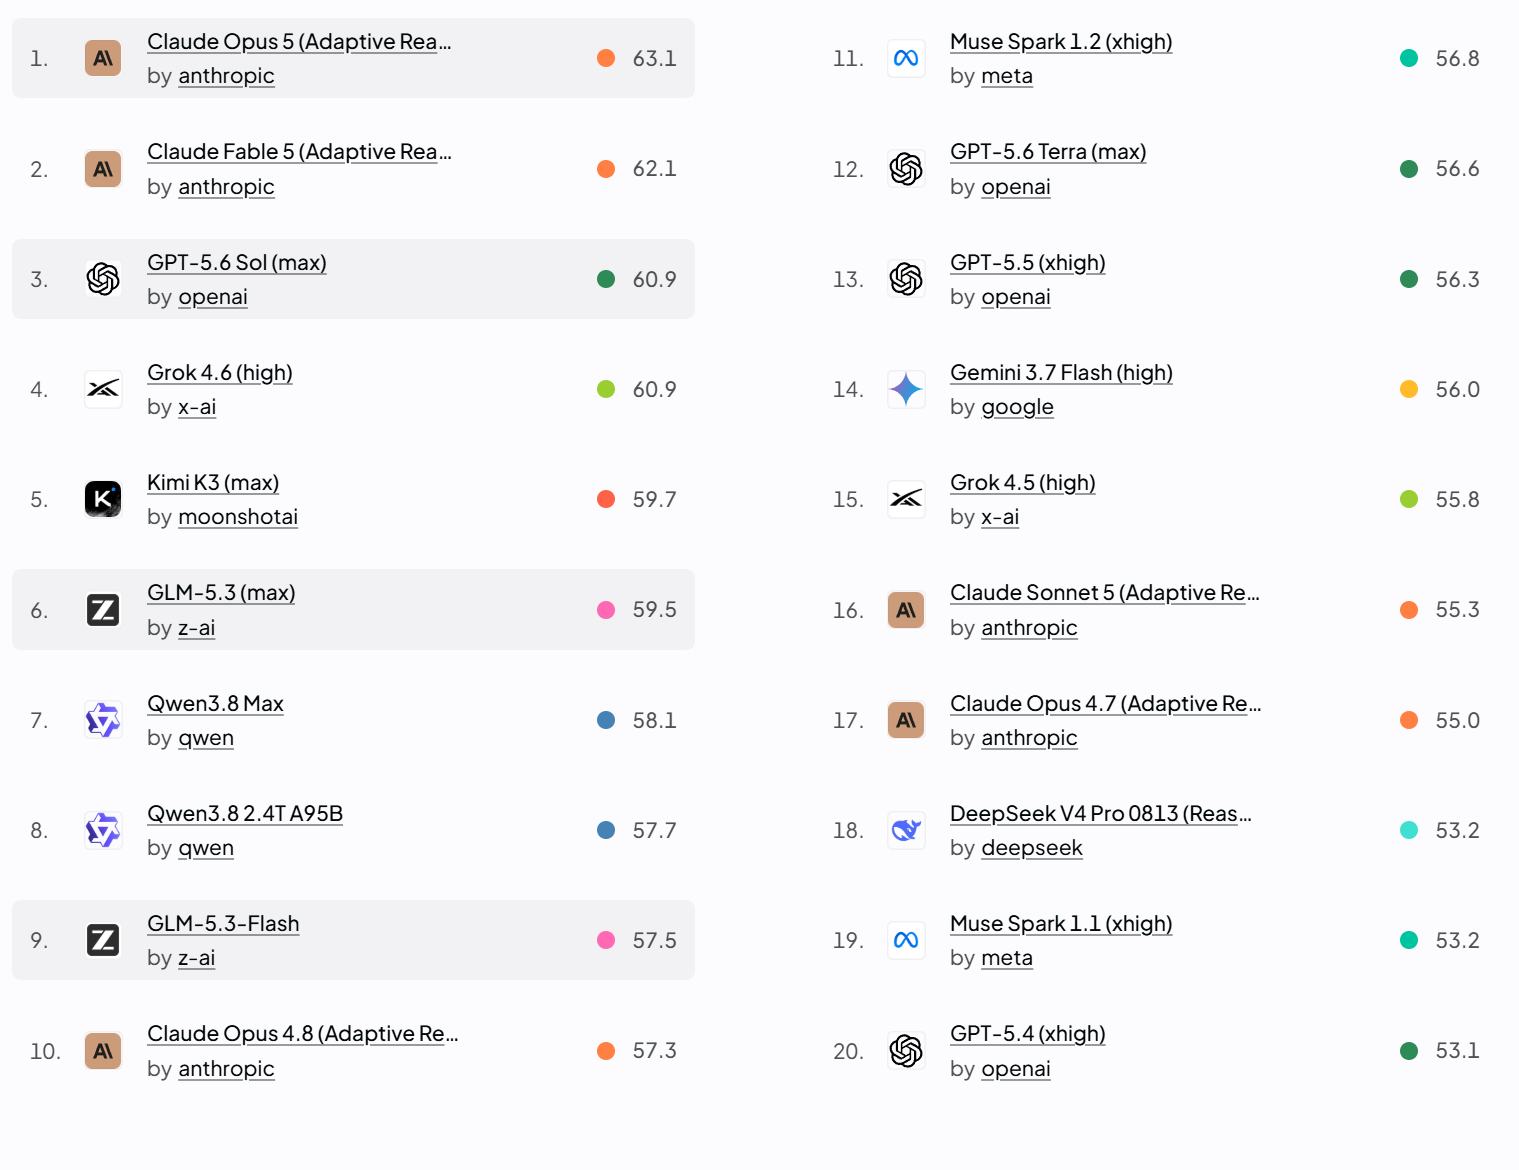
上位20モデル全体を見ると、Anthropicが5モデル、OpenAIが4モデルを送り込んでいます。絶対性能の上位は依然として米国勢が厚く、1位と2位をAnthropic、3位をOpenAIが占めています。
一方で、Z.aiはGLM-5.3が6位、GLM-5.3-Flashが9位に入り、その両方がパレートフロンティア上です。上位20へのモデル数だけでなく、価格を含めた実用的な選択肢として存在感を示した点が今回の大きな変化です。
Qwen、xAI、Metaもそれぞれ2モデルずつ入り、Moonshot AI、Google、DeepSeekも上位20に顔を出しています。単純な一社独走ではなく、性能、価格帯、用途ごとに異なる勢力が競り合う状態です。
このランキングの弱点
Avg Price Per 100 Requestsは直感的ですが、同じ100個の質問を全モデルに与えた厳密な比較とは限りません。モデルごとに、プロンプトの長さ、出力の長さ、用途、推論量、キャッシュ利用などが異なります。高性能モデルには難しく長い仕事が集まり、低価格モデルには短い処理が集まっている可能性もあります。
また、Intelligence Indexは総合指標です。コーディング、日本語、エージェント、長文、画像理解など、用途を限定すれば順位は変わります。パレート線より下のモデルにも、速度、安定性、コンテキスト長、ツール対応、データの取り扱いなどで選ぶ理由があります。
このグラフは候補を絞るための地図として使い、最終判断では自分のプロンプトとデータを使って、成功率、総費用、応答時間を実測するのが確実です。
まとめ
2026年8月29日時点の絶対性能トップは、引き続きClaude Opus 5でした。価格まで含めたパレートフロンティアには、Claude Opus 5、GPT-5.6 Sol、GLM-5.3、GLM-5.3-Flashの4モデルが残っています。
20日前は7モデルで構成されていたフロンティアが、今回は4モデルへ縮小しました。特に、GLM-5.3とGLM-5.3-Flashが低価格側を押さえ、パレート線の半分をGLM系が占めたことが目立ちます。
最高性能のAnthropic、高性能と価格の接点を担うOpenAI、低価格側から迫るZ.ai。2026年8月29日のLLM勢力図は、この三極構造として見ると分かりやすいでしょう。ただし、この地図はすぐに書き換わります。次にフロンティアへ入るのはどのモデルか、引き続き追っていきます。
参考:OpenRouter Rankings/OpenRouter Benchmarks API/前回:2026年8月9日版